вторник, 4 апреля 2017 г.

Новые модули ядра ipfw_pmod, ipfw_nptv6 и ipfw_nat64

Вчера я закоммитил новый модуль для ipfw - ipfw_pmod, а так же смержил в stable/11 модули ipfw_nptv6 и ipfw_nat64.
Во FreeBSD 11.0 в ipfw было добавлено много нового, и среди прочего - поддержка "внешних действий", или external action. Она представляет собой интерфейс, который даёт возможность в рантайме добавлять и удалять в ipfw дополнительные действия для правил (actions, такие как allow, deny, count и прочие) . 
Как это планировалось использовать в теории. Предположим, у нас имеется стоковая FreeBSD, и ряд задач для ipfw, которые строго специфичны для нашей организации, и всем другим людям такие функции вряд ли потребуются. Чтобы не добавлять подобные функции в базовую систему, и в то же время, чтобы упростить поддержку внутри организации (адаптацию патчей с каждой новой версией), были добавлены несколько новых опкодов.
Этих опкодов (сначала их было два, теперь стало три) достаточно, чтобы реализовать практически любую новую функцию в ipfw. Имеются в виду опкоды типа action. Достаточно только подгрузить модуль ядра и правила, использующие эти новые действия будут работать. Даже стоковый бинарник ipfw(8) способен с некоторыми ограничениями отображать такие правила. Для добавления и модификации таких правил необходимо стороннее приложение, исходный код которого менять при обновлении нет необходимости.
В случае если подобный модуль достаточно полезен и для всех других людей, то достаточно включить код для добавления и отображения правил в состав ipfw(8). Ядерная же составляющая остаётся без изменений.
Используя этот интерфейс были созданы три, перечисленные в начале, модуля. Модуль ipfw_pmod предназначен для модификации пакетов различных протоколов. На данный момент он содержит в себе только опкод "tcp-setmss", который как нетрудно догадаться, модифицирует опцию TCP пакета MSS. Правило использующее это действие может выглядеть, например, так:
ipfw add tcp-setmss 1400 tcp from any to any
Работает оно примерно так же, как netgraph модуль ng_tcpmss. Но ещё и поддерживает IPv6. После обработки правилом, действие продолжается со следующего правила. Т.е. правило не прерывает поиск.

Модуль ipfw_nptv6 реализует транслятор IPv6 префиксов и работает по алгоритму, описанному в  RFC6296. Сразу хочу заметить, что трансляция IPv6 префиксов происходит несколько иначе, как можно было бы ожидать. Адреса не транслируются 1 в 1, например 2001:1000::1 не будет оттранслирован в 2a02:6b8::1. Согласно RFC адреса транслируются таким образом, что у транслятора нет необходимости делать пересчёт контрольных сумм. Поэтому в адрес добавляется некоторое число, которое делает вид адреса менее читаемым.
Использование этого модуля несколько отличается от ipfw_pmod. Здесь применяется концепция именованных экземпляров (instance) со своими собственными настройками. Прежде чем использовать nptv6 в правилах, необходимо создать именованный экземпляр и настроить его. После этого уже можно добавлять правила в ipfw:
ipfw nptv6 NPT create int_prefix fd00:dead:c0de:: ext_prefix 2001:470:7ad7:: prefixlen 48
ipfw add nptv6 NPT ip6 from any to any

Модуль ipfw_nat64 реализует транслятор IPv6 в IPv4. Он содержит две реализации stateful и stateless, и тоже использует концепцию именованных экземпляров. NAT64 без отслеживания состояний настраивается при помощи ключевого слова nat64stl. Он использует две таблицы, содержащие отображение IPv6->IPv4 и IPv4->IPv6. Согласен, это не очень удобно, но пока так.
NAT64 с отслеживанием состояний использует ключевое слово nat64lsn. Для его настройки нужен только используемый IPv4 префикс, который определяет количество ресурсов необходимых транслятору.
Оба транслятора используют Well-Known IPv6 префикс для NAT64 64:ff9b::/96. Ну и для работы конечно же нужен работающий DNS64.

пятница, 24 марта 2017 г.

Драйвер для принтера Brother DCP7060D

На прошлой неделе обновил свой рабочий ноутбук. Старенький Lenovo T520 ушёл на покой. Теперь свежая FreeBSD 12.0 установлена на Lenovo X1 Carbon 4th Generation. Пока не всё гладко и особо нет времени глубоко ковыряться, работать можно - этого пока достаточно. 
Решил подключить свой старенький принтер Brother DCP7060D. Раньше я уже адаптировал линуксовый драйвер для него, но так как это было давно, в этот раз установка драйвера не прошла гладко и пришлось заново разбираться.
В итоге, я запаковал изменённые файлики драйвера в архив, если кому-то будет нужно, то взять можно здесь. В идеале было бы здорово сделать порт, но это не такая уж и тривиальная задача, поэтому лучше так, чем никак.
Для работы нужно распаковать архив в /usr/local; установить linux_base, cups, cups-filters и psutils. После этого запустить пару комманд из install.txt, и можно добавлять принтер в cups. Со сканером не разбирался, пока нужды не было.

среда, 22 февраля 2017 г.

Использование if_ipsec во FreeBSD

Как многие уже знают, во FreeBSD 12.0-CURRENT был добавлен новый сетевой псевдоинтерфейс if_ipsec(4). На первый взгляд кажется, что он выполняет те же самые задачи что и уже существующий десятилетия if_gif(4). Но это не совсем так.
Оба интерфейса предоставляют виртуальный туннель, в который может маршрутизироваться трафик. Оба интерфейса настраиваются подобным образом: при помощи ifconfig(8) создаётся интерфейс, ему назначаются адреса конечных точек туннеля, настраиваются адреса внутри туннеля, при необходимости добавляются дополнительные маршруты. В случае с if_gif(4) этих действий уже достаточно для работы интерфейса. Он может принимать и передавать инкапсулированные в IPv4 или IPv6 пакеты.
Чтобы зашифровать передаваемый внутри туннеля трафик необходимо настроить политики и ассоциации безопасности, которые будут применять IPsec преобразования к трафику туннеля, т.е. в качестве селектора адресов для политики должны выступать адреса конечных точек туннеля, а селектором протокола - в зависимости от настроек могут быть различные вариации инкапсуляции IP в IP. Можно конечно "матчить" весь трафик между конечными точками туннеля, но это чаще всего неудобно.   Когда таких туннелей нужно создать много, то встаёт задача синхронизации настроек каждого if_gif(4) туннеля и настроек политик безопасности IPsec. К тому же, наличие большого числа политик безопасности не ускоряет работу по поиску подходящей политики для каждого пакета.
В решении части этих проблем и должен помочь if_ipsec(4). Его особенность в том, что он не выполняет инкапсуляцию сам, как это делает if_gif(4), а использует применяемую для туннельного режима "встроенную" в IPsec инкапсуляцию. При настройке туннеля if_ipsec(4) автоматически создаёт нужные политики безопасности, в которых уже указаны адреса конечных точек туннеля. Стоит заметить, что и принцип применения этих политик отличается от используемого для if_gif(4). Создаваемые интерфейсом if_ipsec(4) политики безопасности "матчат" вообще весь IPv4 и IPv6 трафик. Но так как они привязаны к конкретному интерфейсу, то и "матчат" они только трафик, проходящий через интерфейс.
В итоге можно иметь сотни таких политик безопасности в системе, но при прохождении пакетов поиск подходящей политики вообще не выполняется, т.к. каждый if_ipsec(4) интерфейс выбирает свою единственную политику, которой владеет он. 
На маршрутизаторе, где используется только if_ipsec(4), даже fastforwarding будет работать для всего остального трафика, чего нельзя получить с классическим if_gif(4) и глобальными политиками безопасности, т.к. fastforwarding автоматически отключается при наличии таких политик.
Теперь про особенности настройки. Как я уже сказал, с точки зрения конфигурации интерфейса, всё настраивается точно так же как и для if_gif(4). Но есть один дополнительный параметр reqid. Который может назначаться автоматически, но если не предполагается использовать IKE, то лучше назначить его руками. Этот параметр помагает системе различать политики нескольких интерфейсов и выполнять поиск подходящей ассоциации безопасности.
Ещё одна особенность, отличающая if_ipsec(4) от if_gif(4) - при использовании if_ipsec(4) нет возможности "выключить" IPsec и проверить, что всё работает без шифрования.
Ну и конечно же, настройку ассоциаций безопасности никто не отменял. Пароли и ключи шифрования автоматически никто придумывать за вас не будет. Чтобы ассоциация безопасности начала использоваться интерфейсом if_ipsec(4), нужно при её добавлении использовать специальный параметр у утилиты setkey(8) "-u id", где id - это упомянутый ранее reqid интерфейса. 
Пример создания туннеля между двумя тестовыми машинами test15 и test25:
test15# ifconfig ipsec0 create reqid 145
test15# ifconfig ipsec0 inet tunnel 87.250.242.145 87.250.242.144
test15# ifconfig ipsec0 inet 10.0.0.145/24 10.0.0.144
test15# ifconfig ipsec0
ipsec0: flags=8051 metric 0 mtu 1400
 tunnel inet 87.250.242.145 --> 87.250.242.144
 inet 10.0.0.145 --> 10.0.0.144 netmask 0xffffff00 
 inet6 fe80::225:90ff:fef9:3c92%ipsec0 prefixlen 64 scopeid 0x4 
 nd6 options=23
 reqid: 145
 groups: ipsec 
test15# setkey -c
add 87.250.242.145 87.250.242.144 esp 0xbadcafe -u 145 -E rijndael-cbc "1234567890987654" -A hmac-sha2-256 "12345678901234561234567890123456";
add 87.250.242.144 87.250.242.145 esp 0xcafebad -u 145 -E rijndael-cbc "0987654321123456" -A hmac-sha2-256 "aaaaaaaaaaaaaaaaaaaaaaaaaaaaaa12";
^D

После настройки адресов туннеля на интерфейсе создаются вот такие политики безопасности.
test15# setkey -DP
0.0.0.0/0[any] 0.0.0.0/0[any] any
 in ipsec
 esp/tunnel/87.250.242.144-87.250.242.145/unique:145
 spid=1 seq=3 pid=9427
 refcnt=1
::/0[any] ::/0[any] any
 in ipsec
 esp/tunnel/87.250.242.144-87.250.242.145/unique:145
 spid=3 seq=2 pid=9427
 refcnt=1
0.0.0.0/0[any] 0.0.0.0/0[any] any
 out ipsec
 esp/tunnel/87.250.242.145-87.250.242.144/unique:145
 spid=2 seq=1 pid=9427
 refcnt=1
::/0[any] ::/0[any] any
 out ipsec
 esp/tunnel/87.250.242.145-87.250.242.144/unique:145
 spid=4 seq=0 pid=9427
 refcnt=1
Изменить политики можно только уничтожив интерфейс или изменив его настройки (адреса или reqid). Удалить их при помощи setkey -DPF так же не выйдет.
test25# ifconfig ipsec0 create reqid 144
test25# ifconfig ipsec0 inet tunnel 87.250.242.144 87.250.242.145
test25# ifconfig ipsec0 inet 10.0.0.144/24 10.0.0.145
test15# setkey -c
add 87.250.242.145 87.250.242.144 esp 0xbadcafe -u 144 -E rijndael-cbc "1234567890987654" -A hmac-sha2-256 "12345678901234561234567890123456";
add 87.250.242.144 87.250.242.145 esp 0xcafebad -u 144 -E rijndael-cbc "0987654321123456" -A hmac-sha2-256 "aaaaaaaaaaaaaaaaaaaaaaaaaaaaaa12";
^D
test15# tcpdump -qnvi ix0 host 87.250.242.144
tcpdump: listening on ix0, link-type EN10MB (Ethernet), capture size 262144 bytes
14:28:25.170705 IP (tos 0x0, ttl 64, id 33289, offset 0, flags [none], proto ESP (50), length 156)
    87.250.242.144 > 87.250.242.145: ESP(spi=0x0cafebad,seq=0x3), length 136
14:28:25.170928 IP (tos 0x0, ttl 64, id 4871, offset 0, flags [none], proto ESP (50), length 156, bad cksum 0 (->d212)!)
    87.250.242.145 > 87.250.242.144: ESP(spi=0x0badcafe,seq=0x1), length 136
14:28:45.288935 IP (tos 0x0, ttl 64, id 21702, offset 0, flags [none], proto ICMP (1), length 84)
    87.250.242.144 > 87.250.242.145: ICMP echo request, id 37388, seq 0, length 64
14:28:45.288955 IP (tos 0x0, ttl 64, id 32712, offset 0, flags [none], proto ICMP (1), length 84, bad cksum 0 (->65ca)!)
    87.250.242.145 > 87.250.242.144: ICMP echo reply, id 37388, seq 0, length 64
test25# ping -c1 10.0.0.145
PING 10.0.0.145 (10.0.0.145): 56 data bytes
64 bytes from 10.0.0.145: icmp_seq=0 ttl=64 time=0.508 ms

--- 10.0.0.145 ping statistics ---
1 packets transmitted, 1 packets received, 0.0% packet loss
round-trip min/avg/max/stddev = 0.508/0.508/0.508/0.000 ms
test25# ping -c1 87.250.242.145
PING 87.250.242.145 (87.250.242.145): 56 data bytes
64 bytes from 87.250.242.145: icmp_seq=0 ttl=64 time=0.090 ms

--- 87.250.242.145 ping statistics ---
1 packets transmitted, 1 packets received, 0.0% packet loss
round-trip min/avg/max/stddev = 0.090/0.090/0.090/0.000 ms 

Этот пример показывает как использовать if_ipsec(4) в режиме ручной настройки. Но if_ipsec(4) вполне может использоваться совместно с различными IKE демонами. В этом случае создание политик безопасности от IKE демона не требуется. Ядро запросит у IKEd создание ассоциации безопасности при первой же попытке прохождения пакета через интерфейс, что может инициировать согласование параметров ассоциаций безопасности между IKE.

пятница, 10 февраля 2017 г.

Отключение проверки на "поддерживаемость" модулей для сетевых карт Intel XL710

Новое поколение сетевых карт Intel 710 серии обслуживается во FreeBSD драйвером if_ixl(4). И как это обычно любит делать Intel, если используемый с картой модуль не находится в "белом" списке производителя, то карта отказывается с ним работать. Во FreeBSD это сопровождается такими сообщениями:
ixl0: Link failed because an unqualified module was detected!
ixl1: Link failed because an unqualified module was detected!
ixl2: Link failed because an unqualified module was detected!
ixl3: Link failed because an unqualified module was detected!
В драйвере if_ixgbe(4) для отключения такого поведения была специальная настройка в loader.conf: hw.ix.unsupported_sfp="1".
В этом драйвере такой настройки нет и судя по всему, эта особенность контролируется firmware карты. Т.е. если карта обнаруживает неподдерживаемый модуль, она отказывается с ним работать и никакие проверки в драйвере этому помешать не могут.
Никаких утилит от производителя для настройки этого поведения найти не удалось. В линуксах, судя по архивам рассылок, эта проблема тоже присутствует. И для линукса был найден вот этот репозиторий, в котором содержится две утилиты. Одна для поиска нужной структуры в NVM карты, а вторая для модификации нужных данных. Автору не удалось найти закономерность в расположении данных в NVM, поэтому, видимо, он не оформил утилиты в виде законченного решения.

Проведя несколько часов за чтением спецификации и драйвера, я написал аналог его утилиты поиска нужной структуры для работы во FreeBSD. И разглядывая полученные данные я нашёл закономерность для получения адреса нужной структуры данных. В результате чего появилась на свет  утилита ixl_unlock. Утилита была проверена на работоспособность с версией драйвера ixl 1.6.6 и версией firmware:
dev.ixl.0.fw_version: fw 5.0.40043 api 1.5 nvm 5.05 etid 800028a2 oem 1.262.0
Чтобы проверить, находит ли она нужные данные, надо использовать её с ключиком -g:
# ./ixl_unlock -g ixl0
EMP SR: 0x66ac
PHY CAP DATA OFFSET: 0x67fa
PHY Capability data structure 0:
000067fa  00  0x000b (Section Length) should be 0x000b
000067fa  01  0x0003
000067fa  02  0x0880
000067fa  03  0x00f0
000067fa  04  0x0000
000067fa  05  0x0000
000067fa  06  0x0e0d
000067fa  07  0x0000
000067fa  08  0x0f08 (PHY Capabilities Misc0) <== will be modified
000067fa  09  0x0000
000067fa  0a  0x0a1e (40 LESM Timer Values) should be 0x0a1e
000067fa  0b  0x0001

Если подписанные данные соответствуют действительности, значит утилита будет работать с вашей картой и можно запускать её с ключом -u. Если нет - вероятно что-то изменилось в расположении структур данных в прошивке и утилиту использовать нельзя.

понедельник, 9 января 2017 г.

Новая реализация fastfwd в FreeBSD 11

Не так давно я смержил в stable/11 обновлённую реализацию fastfwd из head/. А сегодня подошло время MFC аналогичной реализации для IPv6. Для тех кто не знает, поясню чем отличается fastfwd от обычной маршрутизации. До выхода 11-ой версии в FreeBSD было две sysctl переменных, управляющих поведением маршрутизатора: net.inet.ip.forwarding и net.inet.ip.fastforwarding. Первая включает собственно обычную маршрутизацию, т.е. пересылку входящих IPv4 пакетов, которые адресованы других хостам. Вторая - включает использование упрощённого варианта, который выполняет меньшее количество действий и не поддерживает IPsec.

Как это реализовано внутри: входящий пакет после обработки канальным уровнем (например, Ethernet) ставится в очередь обработки IP (netisr queue). Далее эта очередь обрабатывается стеком IP - функцией ip_input(). К пакету применяется ряд проверок на корректность, выполняется обработка пакетными фильтрами (на интерфейсе получения), затем определяется необходимость выполнить пересылку (т.к. пакет адресован не нам). После этого пакет передаётся в функцию маршрутизации ip_forward(). Тут у пакета уменьшается TTL, проверяется необходимость применения IPsec преобразований, выполняется поиск маршрута до адреса назначения и пакет передаётся в функцию отправки ip_output(). Здесь опять же выполняется ряд проверок, пакет передаётся на обработку пакетным фильтрам (уже на интерфейсе отправления); выполняется фрагментация, если нужно. И в конце концов пакет отправляется в канальный уровень, где после добавления Ethernet заголовка он передаётся в драйвер сетевой карты.

Вот такая, довольно громоздкая цепочка действий, в случае с включённым режимом fastforwarding, упрощается до следующих действий: входящий пакет сразу из канального уровня передаётся в функцию ip_fastforward(), где выполняются базовые проверки корректности; пакет обрабатывается пакетными фильтрами на интерфейсе получения; находится необходимый маршрут; уменьшается TTL и выполняется обработка пакетными фильтрами на интерфейсе отправления; после чего пакет сразу отправляется в канальный уровень (если нужна фрагментация, она делается тут же).

За счёт уменьшения числа действий и прямого исполнения без использования очередей netisr в итоге этот вариант получает довольно заметный прирост в производительности. Особенно если исключить из этих действий ещё и пакетные фильтры. На многоядерных процессорах и при использовании сетевых карт с несколькими очередями обработки fastfwd получает ещё более заметный прирост.

В FreeBSD 11 режим fastforwarding стал использоваться по-умолчанию. Последовательность обработки немного отличается от того, что описано выше, но принцип получения прироста производительности в общем-то сохранился.

С увеличением числа процессорных ядер и обрабатываемых пакетов в единицу времени на первый план вышла другая проблема. Теперь несколько одновременно выполняемых потоков борются за доступ к общим ресурсам. Например, при маршрутизации в несколько потоков каждый поток хочет получить эксклюзивный доступ к записи в таблице маршрутизации. Что приводит к простою в ожидании доступа. В результате  общая производительность может даже ухудшиться.

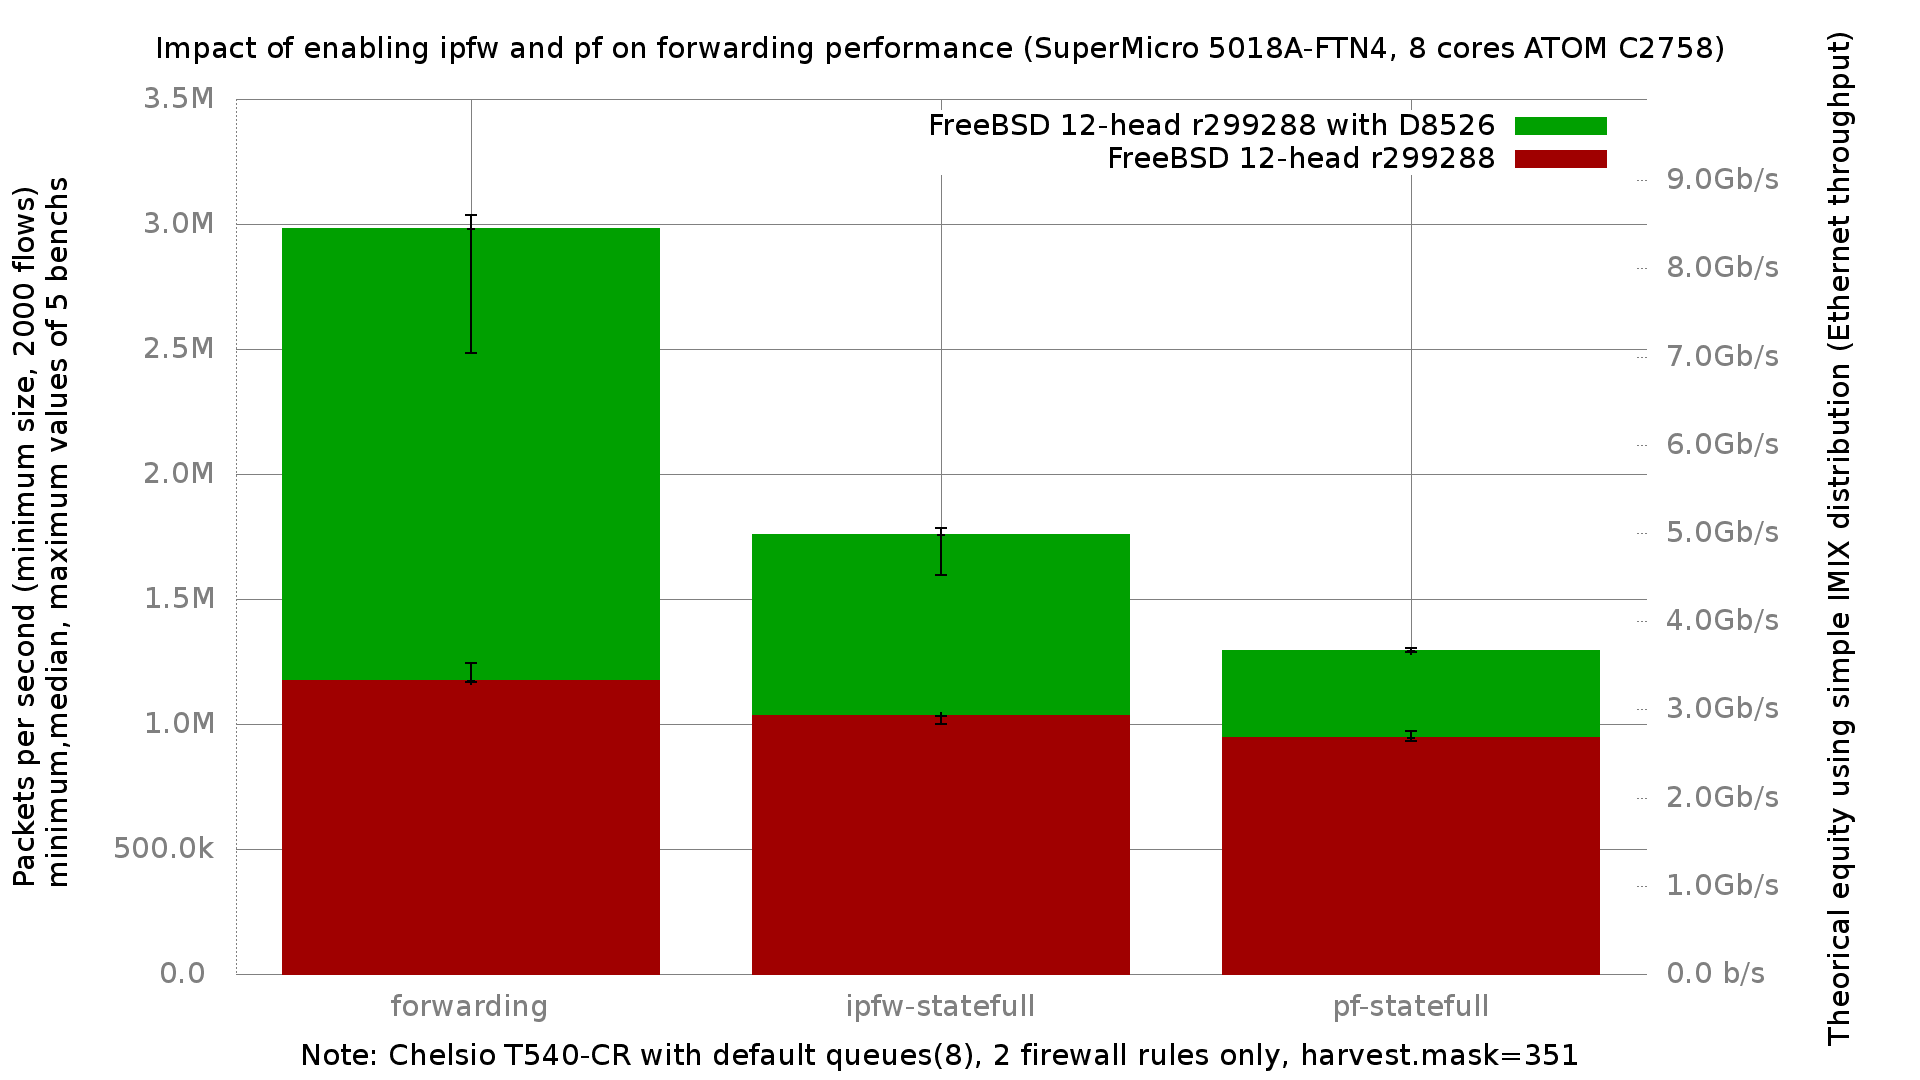
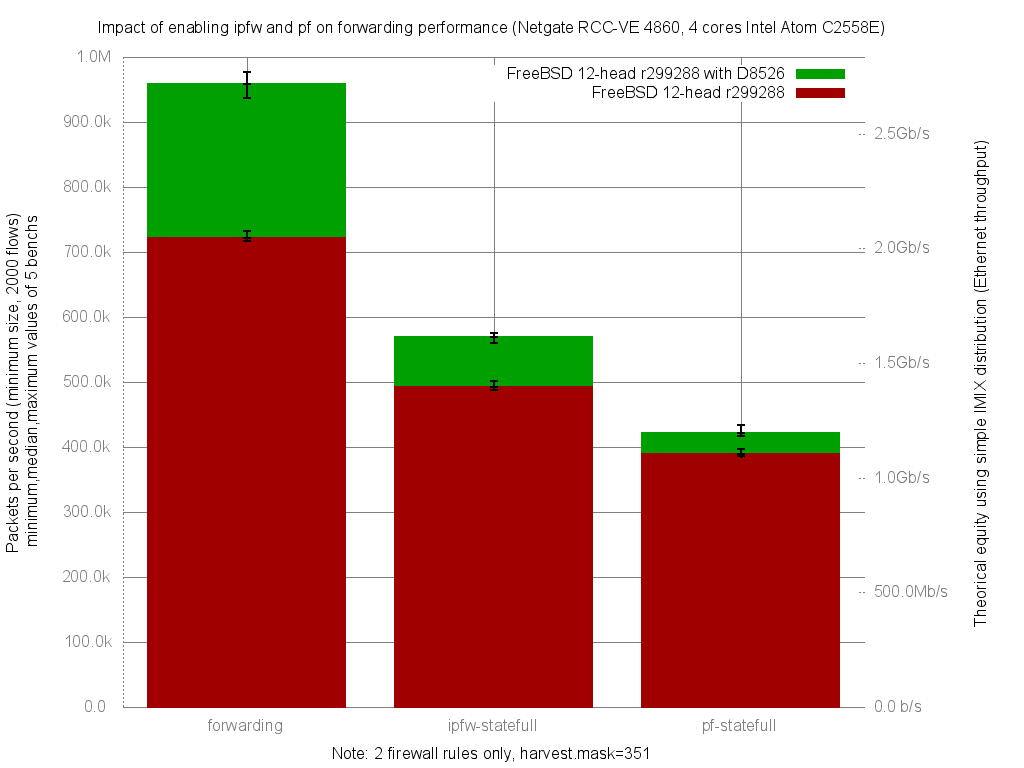
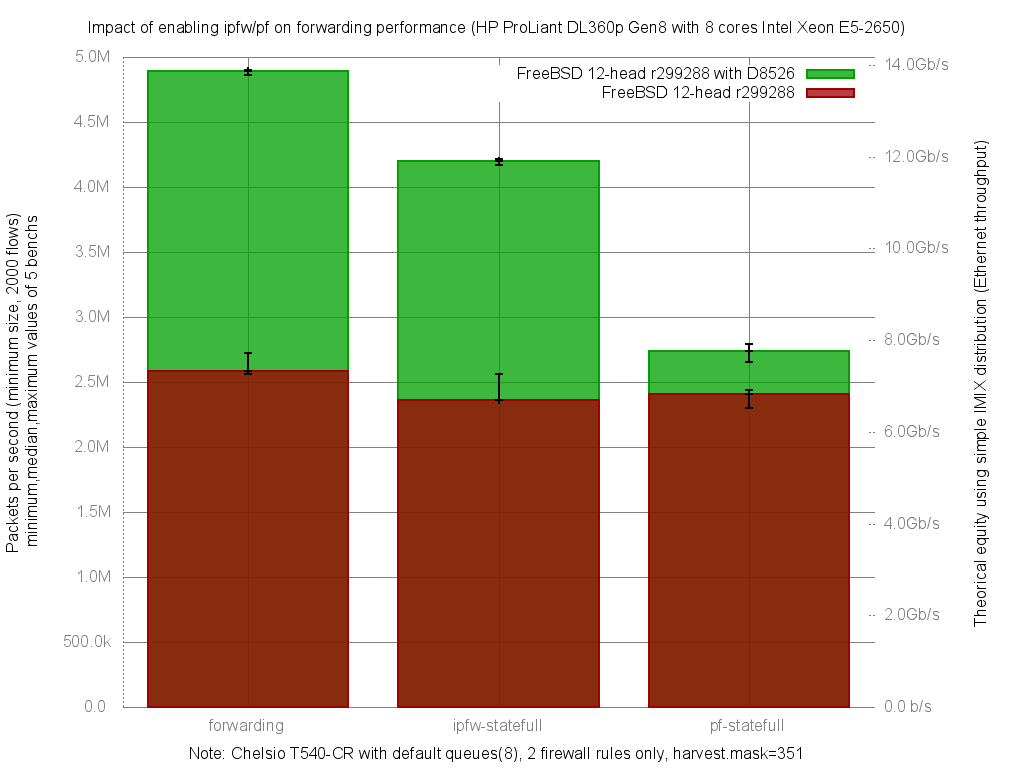
Старый API, используемый для поиска маршрута, обладает таким недостатком. Поэтому обновлённая реализация использует API, который основан на наработках проекта projects/routing. Вот несколько графиков, демонстрирующих изменения в производительности от использования нового API на различном железе:

Тесты и графики построены автором проекта BSD Router Project Olivier Cochard-Labbé. Для IPv6 графиков не нашёл, но тоже можно ожидать примерно такого же роста. Ещё интересный график влияния изменений в FreeBSD CURRENT на производительность маршрутизации за 2016 год:


воскресенье, 11 декабря 2016 г.

Тестирование projects/ipsec

Доброго времени суток.
Хочу предложить читателям (если таковые ещё остались) принять участие в тестировании обновлённой реализации IPsec во FreeBSD. Над этим проектом я в той или иной мере работал последние несколько месяцев. До этого я уже делал несколько "подходов" к коду IPsec, но в основном это были мелкие исправления. Затем измнения стали более сложными, что взволновало некоторых товарищей и меня попросили сначала выкладывать патчи на ревью. :-)
Хотя ситуации это не изменило, ревью делать особо никто не хотел, а я на некоторое время оставил эту область. Но вот, на работе сообщили, что с этим нужно что-то делать - производительность никуда не годится! Это и стало началом projects/ipsec. 
Хочу заметить, что мои изменения не связаны с криптографией, только с сетевыми протоколами. В общем, что сейчас мы имеем в итоге:
  • были переработаны структуры данных SPDB и SADB, правила изменения данных в них; эксклюзивные локи заменены на read-mostly.
  • изменения в SPDB/SADB привели к необходимости переработки реализации PF_KEY и методов обработки входящего и исходящего трафика. На этом этапе я подумал о возможности выделения всего кода IPsec в отдельном месте, что в теории может позволить оформить его в виде модуля ядра.
  • консолидация всего  кода в одном месте вынудила меня разобраться и переделать код подписывания TCP сегментов MD5 сигнатурами. За ним последовал код UDP инкапсуляции, используемый в NAT-T.
  • раз уж я весь код перелопатил, то я решил попробовать сделать специальный туннельный интерфейс if_ipsec, идея по реализации которого уже давно ходит в сети. Вот только некому было.
Это если кратко. Теперь о том, как помочь тестированию. Так как изменений много, все варианты конфигураций проверить я не могу. Если вы с настройкой IPsec на "ты", то сложностей вызывать не должно. Нужно просто обновить какую-либо машину до нужной версии и проверить, не сломалось ли что-то :-)
Если серьёзно, то лучше конечно не экспериментировать с "боевыми" серверами, а выполнять тестирование в лабораторных условиях. Либо в домашних.
Исходный код хранится в отдельном бранче, который основан на FreeBSD 12.0-CURRENT. Патчей для более старых версий нет. Поэтому для тестирования нужно будет установить FreeBSD и обновить её из исходников. Получить исходный код можно, например из svn:
# svn co https://svn.freebsd.org/base/projects/ipsec src
Если кто-то хочет проверить работоспособность NAT-T, я написал небольшой патч к racoon'у, когда пытался протестировать. Патченый порт можно взять тут.
Для тестирования if_ipsec нужно просто создать интерфейс, повесить адреса туннеля на него и добавить соответствующие SA, либо настроить IKEd, чтобы он добавлял SA. Тут есть старые примеры (только сейчас он просто в ядре, не оформлен в виде модуля), небольшое описание того, как он работает тут.

понедельник, 11 января 2016 г.

Восстановление GPT - теперь чуть проще.

Вчера смержил в stable/10 патч, который учит ядро и загрузчик FreeBSD обнаруживать GPT при повреждённом PMBR. У этого есть два эффекта. Во-первых, теперь если повредить первые несколько секторов, то GPT всёравно будет определяться. Не нужно выполнять странных манипуляций с записью /boot/pmbr в первый сектор при помощи dd(1). Второй эффект следует из первого - теперь GPT не уничтожить простым обнулением первого сектора, нужно  обнулять и последний тоже. Проще всего это сделать при помощи gpart destroy. 
Если вдруг, у вас есть диски, где раньше была GPT но потом вы обнулили первый сектор, то GPT может "неожиданно" появиться после обновления. В случае, если в первом секторе находится MBR, то MBR будет иметь более высокий приоритет - это поведение сохранилось. Так что, кажется, положительных моментов в этом изменении больше.
Изменение в загрузчике сделано для случая с несколькими дисками. Если у вас один диск и первые сектора повреждены, то конечно загружаться ничего не будет. Например, можно загрузиться с флешки в загрузчик и выбрать в нём загрузку с диска с повреждённой GPT, т.к. загрузчик тоже будет находить такую GPT.

вторник, 8 декабря 2015 г.

if_enc(4) интерфейс во FreeBSD

Ни для кого, наверное, не новость уже, что IPSec во FreeBSD 11 включён в GENERIC ядро. Но вот if_enc(4) туда включать почему-то не стали. Модулем оно загружаться не умеет, а временами его функционал бывает довольно полезен. Поэтому, вслед за if_gre(4) и if_gif(4), я решил переделать и if_enc(4). Теперь в head/ его можно загружать из модуля, а так же выгружать после использования.
Пару слов для тех кто не знает, для чего он нужен. IPSec  может работать в туннельном и транспортном режимах. В туннельном режиме IPSec код инкапсулирует IP пакет внутрь IP-IP (другими словами - добавляет новый IP заголовок) и затем шифрует. При этом адреса во внешнем заголовке могут отличаться от адресов оригинальной (ещё незашифрованной) IP  дейтаграммы.
Внутри того же IPSec кода есть четыре места (два для входящих пакетов и два для исходящих), из которых происходит обращение к коду if_enc(4) драйвера. В этих местах у пользователя есть возможность посмотреть содержимое пакета, либо отфильтровать его файрволом. Про файрвол многие забывают, и именно поэтому при использовании if_enc(4) можно заблокировать весь IPSec трафик одним лишь поднятием интерфейса ifconfig enc0 up. Пока интерфейс не поднят, оверхеда он практически не создаёт, т.е. не выполняет никаких действий. Как только он поднят, пакеты начинают попадать в bpf(4) и могут быть просмотрены в tcpdump(8), а так же начинают отправляться в pfil(9), откуда, соответственно, попадают на рассмотрение пакетных фильтров.
Для исходящих пакетов в if_enc(4) пакет попадает перед тем как будет добавлен внешний IP заголовок и сразу после добавления. Если используется транспортный режим, то в обоих случаях пакет будет передан без изменений.
Для входящих пакетов, соответственно, сразу после расшифровки, но до того как внешний IP заголовок будет отброшен и после отбрасывания внешнего заголовка. Опять же, для транспортного режима пакет будет тот же самый.
В if_enc(4) имеется возможность контролировать, в каких из этих четырёх точкек мы хотим "видеть" пакеты. Управление осуществляется при помощи sysctl(8) net.enc.[in|out].ipsec_bpf_mask и net.enc.[in|out].ipsec_filter_mask.
Битовая маска определяет из каких мест IPSec кода следует обрабатывать пакеты. ipsec_bpf_mask отвечает за bpf(4), ipsec_filter_mask за pfil(9). Значение 1 включает обработку пакета "до" изменения, 2 - "после". Если хочется видеть оба, нужно использовать значение 3.
Внутри файрвола пакеты полученные из if_enc(4) выглядят как если бы они были получены или отправлены через интерфейс "enc0". И в зависимости от момента, когда вызван обработчик, проверять там нужно соответствующие адреса (внешнего заголовка или внутреннего).

среда, 3 сентября 2014 г.

Отладка ядра при помощи DTrace

Я не могу назвать себя большим специалистом в использовании DTrace, но время от времени я использую возможности этой технологии для отладки на живой системе. Особенно, когда систему нельзя перезагрузить, чтобы добавить в ядро дополнительные отладочные сообщения. В этой заметке я опишу некоторые способы и скрипты для dtrace. Возможно, кому-то они будут полезны, да и самому мне частенько приходится подглядывать в старые скрипты, когда срочно нужно что-то сделать, а уже не помнишь как :)

Всё что необходимо сделать на работающей системе для запуска dtrace:
  1. # kldload dtraceall
  2. # vim script.d
  3. # chmod +x script.d
  4. # ./script.d
Начну с последней задачи, которая ещё свежа в памяти. На маршрутизаторе с нагрузкой примерно 1Mpps на приём и на отдачу в логах время от времени появлялись сообщения от named о невозможности отправки ответа клиенту "error sending response: not enough free resources". При этом счётчик "output packets dropped due to no bufs, etc." в выводе netstat -sp ip растёт со скоростью примерно 100 пакетов в секунду.
% while true; do i=$j; j=`netstat -sp ip | awk '/no bufs/ {print $1}'`; echo $((j-i)); sleep 1; done
99499853
81
86
99
104
79
96
86
94
95
86
Если посмотреть в исходный код named'а, то можно увидеть, что такое сообщение возможно только при возвращении системным вызовом кода ошибки ENOBUFS. В сетевом стеке есть несколько мест, которые могут являться источником такого кода ошибки:
% grep -l ENOBUFS netinet/* net/* | column -c 80
netinet/in_gif.c netinet/sctputil.c net/if_fwsubr.c
netinet/in_mcast.c netinet/tcp_output.c net/if_gre.c
netinet/in_pcb.c netinet/tcp_syncache.c net/if_iso88025subr.c
netinet/ip_divert.c netinet/tcp_timewait.c net/if_spppsubr.c
netinet/ip_input.c netinet/tcp_usrreq.c net/if_stf.c
netinet/ip_mroute.c netinet/udp_usrreq.c net/if_tap.c
netinet/ip_output.c net/if_arcsubr.c net/if_tun.c
netinet/raw_ip.c net/if_atmsubr.c net/ifq.h
netinet/sctp_output.c net/if_bridge.c  net/netisr.c
netinet/sctp_pcb.c net/if_ethersubr.c net/route.c
netinet/sctp_usrreq.c net/if_fddisubr.c net/rtsock.c

Так как речь идёт о протоколе UDP и IPv4 (IPv4 адреса отображаются в сообщении об ошибке), то начиная с верхнего уровня будем спускаться вниз по стеку. Открываем netinet/udp_usrreq.c и смотрим, где может возвращаться ENOBUFS. Параллельно с этим, создаём скрипт для dtrace, чтобы в реальном времени найти функцию, возвращающую этот код ошибки. Одна из функций, которая может вернуть ENOBUFS - udp_output. Но если посмотреть в вывод dtrace -l, то мы не увидим там возможности трассировать эту функцию. Вероятно компилятор оптимизировал её... Придётся смотреть функцию, которая вызывает udp_output, а это - udp_send.
% sudo dtrace -l | grep udp_output
% sudo dtrace -l | grep udp_send
20109        fbt            kernel                          udp_send entry
20110        fbt            kernel                          udp_send return
Функция udp_send имеет такой код:
1756 static int
1757 udp_send(struct socket *so, int flags, struct mbuf *m, struct sockaddr *addr,
1758     struct mbuf *control, struct thread *td)
1759 {
1760         struct inpcb *inp;
1761 
1762         inp = sotoinpcb(so);
1763         KASSERT(inp != NULL, ("udp_send: inp == NULL"));
1764         return (udp_output(inp, m, addr, control, td));
1765 }
Здесь четвёртый аргумент (arg3 - в dtrace нумерация аргументов идёт с нуля) представляет из себя структуру sockadd_in, в которой содержится адрес и порт назначения отправляемой датаграммы. Его можно использовать в нашем скрипте:
% vim script.d
#!/usr/sbin/dtrace -s

fbt::udp_send:entry
{
        self->addr = (struct sockaddr_in *)arg3;
}
fbt::udp_send:return
/arg1 == 55/
{
        printf("%s:%d", inet_ntoa(&self->addr->sin_addr.s_addr), htons(self->addr->sin_port));
}

При запуске скрипта подсистема dtrace будет вызывать функцию fbt::udp_send:entry каждый раз, когда ядро вызывает udp_send. Всё что будет делать наша функция - сохранять указатель на адрес назначения. А обработчик fbt::udp_send:return будет вызываться при завершении функции udp_send, но наличие предиката /arg1 == 55/ ограничит количество вызовов только теми, когда код ошибки, возвращаемый udp_send, будет равен 55 (это числовое значение ENOBUFS). При этом будет напечатан адрес и порт назначения для датаграммы, которую система не смогла отправить (мы сохранили эти данные при входе в функцию).  Наблюдая одновременно за логом системы и за выводом этого скрипта можно сделать вывод, что мы идём верным направлением. Адреса совпадают.
Теперь можно спуститься на уровень ниже - в IP, чтобы убедиться что ошибка происходит не в самой udp_output, а в функции, которую она вызывает - ip_output. Добавляем в script.d такую функцию:
fbt::ip_output:return
/arg1 == 55/
{
        stack(5);
}

И снова запускаем скрипт. Функция fbt::ip_output:return будет вызываться при выходе из ip_output, когда возвращаемое ею значение будет ENOBUFS. При этом будет печататься набор вызовов функций, который привёл в ip_output:
% sudo ./script.d
dtrace: script './script.d' matched 3 probes
CPU     ID                    FUNCTION:NAME
 30  49706                 ip_output:return 
              kernel`udp_send+0x519
              kernel`sosend_dgram+0x2d2
              kernel`kern_sendit+0x1a3
              kernel`sendit+0xdc
              kernel`sys_sendto+0x4d

 30  20110                  udp_send:return XX.88.58.YY:67
 30  49706                 ip_output:return 
              kernel`udp_send+0x519
              kernel`sosend_dgram+0x2d2
              kernel`kern_sendit+0x1a3
              kernel`sendit+0xdc
              kernel`sys_sendmsg+0x87

 30  20110                  udp_send:return XX.8.YY.55:51283

Как видим, udp_send не виновата. ENOBUFS, который возвращает udp_send приходит к ней из ip_output. ip_output может возвращать эту ошибку сама, а может получать от нижнего уровня - Ethernet. Таким образом, опускаясь всё ниже и ниже я добрался до драйвера сетевой карты ixgbe(4). В скрипте dtrace у меня из значимого остался вот такой код:
fbt::lagg_transmit:entry
{
        self->ifp = (struct ifnet *)arg0;
        self->sc = (struct lagg_softc *)self->ifp->if_softc;
}
fbt::lagg_enqueue:entry
{
        self->lp = (struct ifnet *)arg0;
}
fbt::lagg_transmit:return
/arg1 == 55/
{
        printf("ENOBUFS from %s / %d / %s", self->ifp->if_xname,
            self->sc->sc_proto, self->lp->if_xname);
        stack(10);
}

Вывод которого показал:
CPU     ID                    FUNCTION:NAME
 30  56590             lagg_transmit:return ENOBUFS from lagg0 / 4 / ix1
              kernel`vlan_transmit+0xcf
              kernel`ether_output_frame+0x33
              kernel`ether_output+0x4a2
              kernel`ip_output+0xdc0
              kernel`udp_send+0x519
              kernel`sosend_dgram+0x2d2
              kernel`kern_sendit+0x1a3
              kernel`sendit+0xdc
              kernel`sys_sendmsg+0x87
              kernel`amd64_syscall+0x5ea

 30  56590             lagg_transmit:return ENOBUFS from lagg0 / 4 / ix0
              kernel`vlan_transmit+0xcf
              kernel`ether_output_frame+0x33
              kernel`ether_output+0x4a2
              kernel`ip_output+0xdc0
              kernel`udp_send+0x519
              kernel`sosend_dgram+0x2d2
              kernel`kern_sendit+0x1a3
              kernel`sendit+0xdc
              kernel`sys_sendmsg+0x87
              kernel`amd64_syscall+0x5ea

Здесь немного поясню. Когда приложение делает системный вызов sendmsg для отправки датаграммы, мы попадаем в udp_send, затем вызываем ip_output, от туда мы попадаем в ether_output и ether_output_frame, далее в код vlan'а - vlan_transmit, от туда в код lagg(4), на котором создан vlan - lagg_transmit. lagg(4) создан на двух 10G карточках ixgbe(4). И внутри lagg(4) мы получаем ENOBUFS уже от самого драйвера ixgbe. Внутри кода драйвера ENOBUFS без отображения в статистике мы можем получить только при переполнении кольцевых буферов:
 848         err = drbr_enqueue(ifp, txr->br, m);
 849         if (err)
 850                 return (err);

Но и в этом случае ведётся статистика, только доступа к ней нет. Хотя, есть же отладчик! Запускаем kgdb, находим там нужную структуру ifnet, её softc, заглядываем внутрь каждой структуры buf_ring и смотрим на показания счётчика br_drops. Как-то так:
# kgdb
...
(kgdb) set $ifs=ifindex_table
(kgdb) set $i=1
(kgdb) while ($ifs[$i]->ife_ifnet != 0)
 >printf "%i -> %s\n", $i, $ifs[$i++]->ife_ifnet->if_xname
 >end
1 -> igb0
2 -> igb1
3 -> ix0
4 -> ix1
...
(kgdb) set $s=(struct adapter *)ifindex_table[3]->ife_ifnet->if_softc
(kgdb) set $i=0
(kgdb) while ($i < $s->num_queues)
 >printf "%d -> %d\n", $i, $s->tx_rings[$i++]->br->br_drops
 >end
0 -> 24
1 -> 4
2 -> 18
3 -> 7
4 -> 2
5 -> 9
6 -> 9
7 -> 22
8 -> 2
9 -> 1
10 -> 3
11 -> 2
12 -> 2
13 -> 2
14 -> 1046
15 -> 507

В первом цикле мы находим нужную нам структуру ifnet внутри массива ifindex_table. Это структуры с индексами 3 и 4. Ориентируясь на количество очередей внутри драйвера ixgbe(4), выводим на печать содержимое счётчика дропов кольцевых буферов. Как видим, у каждой очереди он не нулевой.
На второй карте было нечто похожее. И это никак не укладывалось в 100 дропов в секунду (в выводе netstat -sp ip). Так как здесь не более 2 тысяч дропов с момента включения сервера.

Что ж, продолжаем искать. В выводе netstat нужный нам счётчик имеет имя ips_odropped (это можно узнать из кода netstat(8), например). Ищем, где этот счётчик изменяется:
% grep -l ips_odropped * | column -c 80
igmp.c  ip_fastfwd.c ip_output.c ip_var.h

igmp.c отбрасываем, т.к. в выводе netstat -sp igmp количество пакетов составляло всего пару десятков. Остаются два кандидата ip_output и ip_fastforward. Для первого мы уже делали dtrace скрипты, и частых срабатываний там не было. А вот ip_fastforward ещё не проверяли. В этой функции счётчик ips_odropped может увеличиваться при любой ошибке полученной от Ethernet уровня:
583         if (error != 0)
584                 IPSTAT_INC(ips_odropped);

Раз ошибка может быть любой, то посмотрим - а какие вообще ошибки возвращает Ethernet уровень?
fbt::ether_output:return
{
        @err[arg1] = count();
}

# ./script.d
dtrace: script './script.d' matched 1 probe
^C

               55                2
               64             4043
                0         34401844

В этом dtrace скрипте я использовал функцию аггреагирования count(). Она сохраняет число вызовов в массив err, где ключём является код возвращаемой ошибки. Теперь смотрим в man errno: 55 код - это ENOBUFS, а 64 - EHOSTDOWN. И тут мы вспоминаем, что когда роутер не может определить L2 адрес хоста назначения, он возвращает эту ошибку из функции arpresolv. Кстати, в коде той же функции ведётся статистика для протокола ARP, которую можно увидеть в выводе netstat -sp arp:
$ while true; do i=$j; j=`netstat -sp arp | awk '/dropped/ {print $1}'`; echo $((j-i)); sleep 1; done
101807936
93
101
106
79
93
78
104
100
89
^C
Примерно вот так знание кода системы, некоторые навыки работы в отладчике и использование dtrace помогают убить время :)

вторник, 12 августа 2014 г.

kern.geom.part.mbr.enforce_chs

Сегодня добавил в FreeBSD 11 sysctl kern.geom.part.mbr.enforce_chs, который позволяет отключить автоматическое выравнивание по дорожке диска в MBR. Теперь, если у вас диск с 4k секторами, создаваемый раздел можно будет без проблем выравнять по границам сектора. В 10-ую и 9-ую версию будет MFC, но там это нужно будет отключать с помощью этого sysctl, либо при помощи настройки в loader.conf.

вторник, 1 июля 2014 г.

Реализация disklabel64 для FreeBSD

В этом посте я хочу рассказать о не так давно добавленной поддержке disklabel64 в GEOM_PART. Эта "таблица разделов" используется в DragonFlyBSD. На сколько я могу судить по коду, используется она там по-умолчанию. Я не являюсь пользователем DragonFlyBSD, но не смотря на это, я подписан на их рассылку для разработчиков, в которую посылаются commit messages. Так как это всё же форк FreeBSD, то их кодовая база пока ещё довольно близка к FreeBSD и там бывают интересные коммиты.
disklabel64 является неким гибридом GPT и disklabel, используемой во всех BSD. Число 64 в названии намекает на то, что все смещения и размеры внутри метаданных являются 64-битными, в отличие от disklabel, где они были 32-битными. Ещё одно важное отличие - в 64-битной версии все смещения указаны в байтах, а не в секторах. Это, при соблюдении некоторых условий, должно позволить disklabel64 оставаться работоспособной при изменении размера сектора. Например, когда у вас есть диск, где размер сектора можно переключить перемычкой. Если создать disklabel64 на диске, у которого размер сектора 512 байт, а потом через некоторое время переключить его на 4096 байт, то для пользователя ничего не изменится. А в GPT такой трюк не получится. Полезность этого функционала конечно довольно сомнительна, но она заложена в дизайн.
По-умолчанию disklabel64 может иметь 16 разделов, но резервирует место для 32. Они так же как в disklabel именуются буквами латиницы. Но для совместимости со старым софтом, раздел 'с' недоступен для пользователя. Если кто-то не помнит, то раньше в disklabel этот раздел адресовал весь диск или раздел, на котором находится disklabel. В disklabel64 пользователь не может обратиться к области метаданных через разделы. Т.е. метаданные защищены от "самоуничтожения". В disklabel если вы специально не позаботились и не создали раздел 'a' со смещением относительно начала диска, то у вас имеется возможность уничтожить метаданные выполнив запись на раздел.
Сами разделы обзавелись UUID'ами. Каждый раздел имеет свой уникальный UUID. Тип раздела может быть указан двумя способами - так же как в disklabel при помощи 8-битного числа, либо как в GPT при помощи UUID. Сама disklabel64 тоже имеет UUID, а так же 64 байта для символьной метки. Т.е. при желании можно добавить соответствующую поддержку в geom_label и использовать эти UUID'ы как метки.
Место для загрузочного кода резервируется между метаданными и началом доступного пользователю места для создания разделов. По-умолчанию это 32 кбайта.
В метаданные заложена возможность наличия резервной копии, но пока что она нигде не реализована.

Если у вас установлена DragonFlyBSD, то теперь у вас есть возможность обратиться к её разделам. Если конечно вы используете UFS :)

среда, 20 ноября 2013 г.

Изменение размера зеркала GEOM_MIRROR

Недавно мне был задан вопрос о том, как можно изменить размер зеркала, созданного при помощи geom_mirror(4), после замены дисков на бОльшие? Честно говоря, самому использовать geom_mirror мне довелось немного, а после появления zfs и совсем как-то перестал. Но посмотрев в код, понял, что простого способа нет.

В итоге требуемый функционал был добавлен и сейчас он уже включён в 11.0-CURRENT. Теперь, после того как вы заменили диски и они синхронизировались, можно выполнить команду gmirror resize и изменить размер зеркала. Тут я применил подход, используемый в gpart(8). Если пользователь при выполнении команды не указывает конкретный размер, то размер расчитывается автоматически до максимально доступного. Т.е. команда:
# gmirror resize gm0

просмотрит все компоненты зеркала, определит максимально доступный размер и установит его.

Впрочем, с помощью ключа -s можно задать и конкретный размер, который может быть и меньше текущего. Но если зеркало используется, то уменьшение зеркала выдаст ошибку EBUSY.

Кроме того, я добавил реализацию метода g_resize, про который я упоминал в предыдущей заметке. Теперь, если родительский провайдер изменит свой размер, то geom_mirror автоматически запишет свои метаданные в "новый" последний сектор. Это может быть использовано, например, при зеркалировании разделов. После изменения размера раздела при помощи gpart resize метаданные gmirror будут автоматически обновлены и записаны в последний сектор. Останется только выполнить ту же процедуру для второго компонента и сделать gmirror resize.

вторник, 12 ноября 2013 г.

Автоматическое изменение размера в GEOM_PART

Некоторое время назад Edward Tomasz Napierala выполнял проект, который позволяет изменять размеры файловых систем без необходимости их размонтирования (при определённых условиях конечно). В результате выполнения этого проекта у GEOM появились новый метод класса g_resize и вспомогательная функция g_resize_provider(). Так же были сделаны соответствующие изменения для некоторых GEOM классов, чтобы задействовать новый функционал.

Теперь несколько слов о том, как это работает.  В качестве целевой аудитории пользователей этого функционала предполагались владельцы умных СХД (систем хранения данных), которые могут динамически изменять размеры своих виртуальных дисков. Администратор такой системы может подвигать ползунком в веб морде СХД (например) и увеличить размер виртуального диска. Эта информация может быть донесена до SCSI диска, а драйвер диска передаёт её geom объекту класса GEOM_DISK. Geom объект вызывает функцию g_resize_provider() и это запускает цепочку действий по информированию всех consumer'ов этого диска об изменившемся размере. Если GEOM класс consumer'а имеет реализацию метода g_resize, то этот метод будет вызван. Таким образом GEOM класс может обработать это событие и выполнить какие-то свои действия.

Как же этот новый функционал можно применить в GEOM_PART? Самое малое было реализовано Эдвардом в рамках выполняемого им проекта - он сделал так, чтобы при выполнении команды gpart resize вызывалась функция g_resize_provider().  Это позволило по аналогии с цепочкой передачи события об изменении размера диска "СХД - драйвер диска - consumer'ы диска" реализовать цепочку "пользователь - раздел в таблице - consumer'ы раздела".  Т.е. теперь, все consumer'ы подключённые к разделу, размер которого изменился, могут что-то предпринять в ответ на это событие.
Если же диск меняет размер, то очевидно, что информация в метаданных таблицы разделов может перестать соответствовать действительности.  И здесь были нужны несколько большие изменения.

В итоге в FreeBSD 11.0-CURRENT сейчас сделано следующее. Для класса GEOM_PART реализован метод g_resize и теперь, при получении события об изменении размера родительского провайдера, будет произведена корректировка метаданных. Но, чтобы уменьшить вероятность совершения тяжело поправимых ошибок со стороны пользователя, эти изменения в метаданных не записываются сразу же на диск. Вместо этого в консоль выводится сообщение "GEOM_PART: %s was automatically resized" и диск помечается как "modified". Увидев такое сообщение в консоли или в системном журнале сообщений, пользователь должен сам решить, хочет он сохранить эти изменения или нет. Для сохранения ему необходимо выполнить команду gpart commit, или сделать любые изменения в таблице разделов, которые вызывают gpart commit неявно.

Это реализовано практически для всех поддерживаемых таблиц разделов, за исключением LDM и GPT. GPT имеет возможность быть помеченной CORRUPT, и для неё может быть использована команды recover, так что не особенно актуально. А LDM поддерживается в режиме только для чтения.

четверг, 11 апреля 2013 г.

PCPU счётчики в ядре

Несколько дней назад Глеб Смирнов (glebius@) добавил в ядро FreeBSD 10-CURRENT новое API для работы со счётчиками - counter(9). Счётчики в системе используются для ведения статистики. Обычно это структура данных, значения полей которой изменяются при возникновении тех или иных событий. Например, получение сетевого пакета, обнаружение некорректных данных, подсчёт количества определённых действий совершённых системой и т.п. Некоторые счётчики изменяются относительно редко, а некоторые могут изменяться миллионы раз в секунду. Ядром используется обычно два способа их изменения - это простой инкремент (операция добавления) или атомарное добавление (atomic(9)). 
У обоих методов есть недостатки. Обычный инкремент на многопроцессорных/многоядерных системах приводит к потере данных, т.е. когда несколько ядер одновременно изменяют одну и ту же переменную, выполнить это удаётся, грубо говоря, только одному ядру. Поэтому статистика временами заметно не соответствует действительности.
Атомарные операции не теряют данные благодаря блокированию шины памяти, что значительно сказывается на скорости выполнения. 
Общим недостатком является то, что изменение счётчика приводит к инвалидированию cache line, в которой находится счётчик из кешей процессоров, что опять же отрицательно сказывается на производительности.
Теперь о том, как эти проблемы решает новое API. Для каждого ядра процессора выделяется своя область памяти, а счётчики преобразуются таким образом, что каждому ядру соответствует своя копия счётчика. Поэтому, даже при одновременном изменении счётчика несколькими ядрами, каждое ядро будет изменять свой счётчик. При этом не будет происходить блокирование шины памяти, не будет потери данных и не будет вымывания кеша, т.к. каждое ядро обращается к своим данным. 
Чтобы обновить счётчик, нужно вычислить адрес счётчика в памяти приватной для данного ядра, а затем произвести его изменение. Для того чтобы в это время контекст не мигрировал на другое ядро, используются критические секции. Однако, не на всех архитектурах это необходимо и с помощью некоторых know-how удаётся избежать использования критических секций. В частности, на нашей основной архитектуре amd64 обновление счётчика осуществляется в одну процессорную инструкцию!
Для того чтобы прочитать значение счётчика, нужно сложить значения копий счётчика со всех ядер. Ну и объём памяти, занимаемый счётчиком, конечно же стал в несколько раз больше (в зависимости от числа ядер процессоров).
Это, на мой взгляд, приемлемая плата вот за какие результаты:
  • в ряде тестов новые счётчики показывают повышение производительности примерно на 63% по сравнению с обычной операцией инкремента, но при этом нет потерь данных, а обычный инкремент теряет 98% данных;
  • в сравнении с атомарными инкрементами новые счётчики в 22 раза быстрее;
  • на реальных тестах по приёму сетевого трафика замена счётчиков IP статистики приводит к снижению нагрузки на CPU примерно на 50%.

воскресенье, 2 декабря 2012 г.

Что нового?

Начнём с того, что я сменил работу, и теперь она напрямую связана с FreeBSD. Теперь у меня больше времени и возможностей, которые можно направить на улучшение системы. Правда, работодатель рассчитывает, что я буду прикладывать их в другое русло - оптимизация сетевой подсистемы и ipfw. Чем я и занимаюсь :)

Первой ласточкой стало то, чего давно хотелось. Ещё когда я не был коммитером, хотелось чтобы ipfw fwd работало без перекомпиляции ядра. Но тогда на моё предложение возразили, что этот функционал значительно снижает быстродействие сетевой подсистемы. Но как показали испытания, никакого снижения замечено не было. В системе хватает других мест, которые вносят значительные "тормоза".

Итак, вероятно некоторые уже заметили, что в src/UPDATING появилась запись, информирующая об удалении опции IPFIREWALL_FORWARD. Теперь этот функционал работает "из коробки", достаточно просто загрузить модуль ядра ipfw.ko. В stable/9 это изменение уже тоже есть, но в релиз оно не попадёт.

Другим крупным шагом был MFC изменений в загрузчике в stable/9. Теперь код загрузчиков в 9-ке практически идентичен тому, что в 10-ке. Я ещё думаю о переносе изменений в 8-ку, но, честно говоря не хочется этого делать. Уж очень сильно в 8-ке он отличается и придётся сделать MFC ещё для кучи ревизий. Так же, можно поблагодарить Андрея avg@ за исправление проблемы в загрузочном коде, которая обнаруживалась на некоторых "кривых" BIOS.

Кроме того, был осуществлён первых подход к изучению и тестированию IPv6 стека на производительность. Который показал плачевное состояние в этой области. Правда, благодаря профилированию и нескольким небольшим изменениям, удалось улучшить результаты почти в три раза. Не буду озвучивать цифры, они сильно зависят от железа. Но факт в том, что оптимизация IPv6 во FreeBSD - это ещё "напахано поле". Впрочем, в IPv4 базовая система тоже не блещет результатами и всего несколько строк в /boot/loader.conf и /etc/sysctl.conf может улучшить эти результаты в разы.

воскресенье, 30 сентября 2012 г.

loader(8): оптимизация и результаты.

Наконец-то я нашёл время и ресурсы на проведение оптимизации в загрузчике системы. Организовал стенд на базе VMWare ESXi, в которой я создал несколько виртуалок с FreeBSD 10, установленных с использованием различных комбинаций таблиц разделов и файловых систем. Расшарил по NFS рабочий каталог с исходниками системы со своей машины, подключил его к виртуалкам и начал отладку... Ну как "отладку", добавил несколько printf'ов в libstand и в драйвер диска biosdisk; включил отладку в недавно добавленном модуле с DISK API; в виртуалках создал файл /boot.config с опциями "-D -S115200", в VMWare настроил запись вывода с последовательного порта в файл и начал тесты.

Получив логи, начал смотреть код и искать способы уменьшения количества дисковых операций, которых оказалось великое множество. В итоге, в модуль с DISK API был добавлен код кеширования обращений к дискам. А нужно сказать, что почти каждое открытие файла с использованием libstand приводит к чтению метаданных таблиц разделов. Чтобы уменьшить это число обращений раньше использовался bcache - блочный кэш. Но, printf'ы внутри дискового драйвера показали, что его эффективность довольно низка, а при использовании GPT - совсем удручает.

Итак, новый кэш работает по другому. При открытии файла, запрос open() приводит к вызову функции devopen(), которая и "открывает" текущее устройство (обычно диск, с которого происходит загрузка), например, disk1p3. Открытие диска - это чтение его метаданных, поиск таблиц разделов и определение смещения, с которого начинается открываемый раздел. Каждое успешное открытие добавляет в кеш запись. Таким образом, при открытии следующего файла на этом диске, уже не нужно будет читать метаданные, а смещение будет прочитано из кэша. В результате, если раньше при загрузке с UFS чтение метаданных выполнялось примерно 50 раз (с учётом попаданий в блочный кеш - около 30), то сейчас это происходит 1 раз.

Далее меня заинтересовало почему при открытии, например, ядра или его модулей, в логе загрузки эта операция отображается несколько раз (от трёх до четырёх)? Т.е. конечно чтение всего ядра не происходит четыре раза, но каждое открытие сопровождается чтением некоторого объёма данных, и только последнее открытие читает заметно больший объём данных. Как оказалось, для архитектуры x86/x64 loader одновременно поддерживает несколько форматов ELF - 32-битные и 64-битные. Причём в массиве, где перечислены указатели на обработчики этих форматов первыми стоят 32-битные, а затем уже 64-битные. Поэтому loader при загрузке модулей ядра в цикле "пробует" модуль каждым обработчиком, пока не найдёт подходящий. И так как у меня тестовые машины 64-битные, то обработчик ядра стоит  3-им в этом массиве, а обработчик модулей ядра - 4-ым.

В общем, эта досадная несправедливость в отношении 64-битных систем была мной ликвидирована тоже. В итоге, я сравнил результаты по затратам времени загрузки с момента старта loader'а и до момента запуска ядра в разных конфигурациях системы:

UFS+GPTZFS+GPTZFS+GPT+несколько дисков
Старый loader7,203 сек20,584 сек26,079 сек
Обновлённый loader4,334 сек9,422 сек11,245 сек

Во всех случаях, кроме самого ядра загружалось ещё несколько модулей.

суббота, 1 сентября 2012 г.

FreeBSD mini-summit в Москве

25-го августа в Москве состоялся уже второй саммит разработчиков FreeBSD. Как и в прошлый раз он проходил в офисе компании Рамблер, правда сейчас это уже был новый офис :)
Формат встречи был прежним - доклады, вопросы, затем обсуждения. Так как народу в этот раз было поменьше, а места было побольше, то обсуждения получились интересными и продуктивными.

Первый доклад сделал Максим Евменкин из компании Netflix. Честно говоря, я об этой компании раньше слышал немного, а оказывается заграницей она довольно известна. Компания предлагает решения по доставке медиаконтента, причём организованы эти решения на основе FreeBSD. Сборка FreeBSD 9-STABLE, из которой убрано всё лишнее, установлена на зеркало из двух SSD внутри "чёрного ящика", в который дополнительно установлено ещё несколько десятков 3-4 ТБ жестких дисков. Неожиданным для меня стало то, что на этих дисках используется UFSJ. Как рассказал Максим, почти единственное, чем система отличается от обычной FreeBSD - несколько патчей к драйверам сетевых карт Intel, все остальные изменения и исправления они стараются возвращать в базовую систему. А патчи для карт Intel являются довольно специфичными и наталкиваются на непонимание/нежелание майнтейнера драйвера. 
Что ещё хотелось бы упомянуть - это используемое ими решение для автоматического обновления системы. Принцип такой: на SSD носителях используется GPT и два зеркалируемых раздела. Одно зеркало - это текущая рабочая система, второе - место, куда записывается новая "firmware". Перед перезагрузкой на разделы, куда записалась прошивка устанавливается FreeBSD-specific GPT атрибут bootonce, который говорит загрузчику gptboot пробовать загружаться сначала с указанного раздела. Если загрузка не удалась, либо произошла паника и т.п., то при следующей загрузке система будет загружаться снова с первого зеркала, которое является рабочим. Подробнее об этом атрибуте можно прочитать в странице gpart(8).

Глеб Смирнов подготовил доклад о работе, проделанной им над пакетным фильтром pf в отдельном бранче projects/pf. Теперь pf стал значительно эффективнее работать на SMP системах, что, например, можно увидеть на графике загрузки тестовой машины.

Константин Белоусов рассказал о причинах возникновения дэдлока между подсистемами VM и VFS, какие методы были опробованы им для решения этой проблемы, и как в итоге  проблема была решена.

вторник, 7 августа 2012 г.

Обновление загрузчика

После долгого перерыва, не дождавшись каких-либо комментариев, я наконец-то закоммитил большую часть изменений в коде загрузчика в head/ ветку.

Немного об изменениях. Было добавлено два программных интерфейса, назовём их PART и DISK. Первый предоставляет функции для работы с различными таблицами разделов: поиск метаданных таблиц разделов, парсинг и формирование списков разделов, получение информации по каждому разделу и т.п. На данный момент поддерживаются GPT, MBR, EBR, BSD label и VTOC8. Набор поддерживаемых таблиц разделов определяется переменными make на этапе компиляции. Обычно это GPT, MBR+EBR и BSD label.

PART API можно использовать напрямую, как это теперь делает ZFS, либо через DISK API. DISK API предназначен для использования в дисковых драйверах загрузчика. Интерфейс вобрал в себя всё общее, что есть между драйверами дисков загрузчиков разных аппаратных архитектур. Это позволило, во-первых, значительно упростить код драйверов, а, во-вторых, унифицировать алгоритмы их работы относительно определения таблиц разделов. Причём, эти алгоритмы почти на 100% совпадают с используемыми ядром. Поэтому, теперь не должно возникать ситуаций, когда загрузчик видит одни разделы, а ядро другие. Раньше такое было вполне возможно.

Основные особенности, которые попали в CURRENT:
  • теперь loader умеет считать контрольную сумму для GPT заголовка и таблицы, а так же использовать резервную копию GPT;
  • PMBR так же научился работать с резервной GPT;
  • в качестве дополнительного бонуса, улучшенная поддержка EBR позволяет загрузить систему с логического тома. Правда boot0 делать этого не умеет, на сколько я помню.
  • Так как ZFS научилась читать таблицы разделов, теперь она не перебирает все возможные комбинации разделов, а тестирует только те, на которых ZFS может быть установлена. Т.е. это разделы с типом "freebsd" и "freebsd-zfs", так что, если у вас есть загрузочный пул на разделах с другим типом, это нужно исправлять.
От идеи с определением метаданных GEOM в загрузчике пока отказались. Так же остались ещё патчи для uboot и архитектур arm/powerpc, которые так никто и не протестировал.

Мой студент в GSoC прошёл первый "отборочный тур", пока с небольшим отставанием от графика, но надежда на то, что скоро у нас на x86 заработает загрузка через EFI есть.

Дальше я планирую провести серию тестов по загрузке системы в различных конфигурациях с разным размером дискового кеша. Сейчас по-умолчанию его размер всего 16 Кбайт, и как показали первые тесты, его увеличение даёт прирост в скорости загрузки на несколько секунд, по крайней мере на моей машине.

В свободное время почитал код различных библиотек, утилит, загрузчиков и UEFI шелла, а так же документацию, какую удалось найти. Теперь уже гораздо лучше представлю, как будет работать наш UEFI загрузчик. Так что, если студент не справится, его работа не пропадёт даром :)

среда, 27 июня 2012 г.

Тестирование патчей для загрузчика

Прошло уже почти три месяца со дня публикации сообщения о патчах к загрузочному коду. И вот, на прошлой неделе я решил заняться этим вплотную. В итоге, создал бранч в SVN, куда стал коммитить свои наработки. Теперь все жалющие принять участие в тестировании могут это сделать :)

Историю изменений можно посмотреть здесь: http://svn.freebsd.org/base/user/ae/bootcode/
Патч относительно 10-CURRENT тут: http://people.freebsd.org/~ae/boot.diff

Какие изменения были сделаны:
  1. На основе кода, используемого в GEOM_PART были написаны функции, предоставляющий интерфейс для поиска таблицы разделов на носителе и выдачи информации о разделах.
  2. Было удалено много старого, дублирующегося кода.
  3. Похожий по назнаению код в "драйверах" дисков  загрузчика был унифицирован и объединён в нескольких функциях, а так же переписан с использованием нового API работы с таблицами разделов.
  4. zfsloader был научен использовать информацию о таблицах разелов, что значительно ускорило его работу на системах, в которых установлено много жёстких дисков.
  5. loader теперь умеет полноценно работать с GPT, т.е. проверяеят контрольные суммы, в случае необходимости умеет находить резервную копию GPT.
  6. В код PMBR так же внесены изменения, которые научили его находить резервную копию GPT, только CRC он не проверяет из-за ограничений на объём кода.
  7. gptboot и PMBR при обнаружении повреждений в заголовке основной таблицы GPT ищут резервную копию в последнем секторе. Если же там её нет, но есть метаданные GEOM класса, то они смотрят в предыдущем секторе. Т.е. теперь, иметь GPT внутри GEOM_MIRROR стало ещё безопаснее, даже в случае поверждения основной таблицы, загрузочный код сможет найти резервную.
На 9-ку патчи пока не накладываются, возможно после выходных avg@ сделает MFC нескольких своих изменений в коде, обеспечивающем загрузку с ZFS, тогда будет возможность тестировать и на STABLE.

понедельник, 2 апреля 2012 г.

Проблемы в работе zfsloader во FreeBSD

Сначала небольшой оффтопик - поддержка LDM уже включена во FreeBSD 10-CURRENT и в ближайшие пару недель будет перенесена в STABLE. В отличие от первоначальных патчей, текущая реализация умеет работать с дисками, размеченными GPT. А в остальном всё осталось примерно так же.

Теперь о теме сообщения. Возможно некоторые из вас замечали, что при загрузке FreeBSD c ZFS в качестве корневой файловой системы, наблюдается некоторая задержка между идентификацией дисков и началом загрузки ядра. Эта задержка в ряде случаев (например, большое количество дисков; много разделов; система в гостевой виртуальной машине) может составлять довольно ощутимое время.

Потратив некоторое время на изучение кода в каталоге sys/boot, могу сделать вывод, что работа нашего загрузчика zfsloader далеко не оптимальна. И корни этой проблемы растут с давних времён.

Во-первых, на данный момент из-за "ограниченности vs. универсальности" интерфейса libstand(3) нет никакой возможности определить количество найденных дисков из кода инициализации ZFS. Поэтому ZFS просто последовательно пробует открыть каждый диск поддерживаемый загрузчиком, а это 32 штуки (от "disk0:" до "disk31:").

Во-вторых, опять же, нет никакой возможности из кода инициализации ZFS узнать тип таблицы разделов и количество разделов в ней, чтобы проверить наличие ZFS на этих разделах. Поэтому выполняется простой перебор всех возможных разделов из диапазона от 1 до 128, например, выполняется попытка откыть "disk0p1:", если не удалось, то делается попытка открыть "disk0s1:" и т.д. до 128.

В-третьих, из-за привязанности к интерфейсу libstand(3), код работы с дисковыми устройствами выполняет чтение таблицы разделов, её проверку и т.д. на каждый вызов open(2). Т.е. когда код инициализации ZFS открывает "disk0:", затем открывает каждый его раздел. Все эти действия приводят к повторному чтению таблицы разделов.

Это частично компенсируется наличием уровня блочного кэша (да, даже у загрузчика он есть). Но размер его всего 16 кБайт, поэтому промахи имеют место быть, особенно для случая с GPT, когда таблица разделов занимает от 34 секторов.

В-четвёртых, для случая с GPT не проверяется ни контрольная сумма, ни резервная таблица с заголовком. Т.е. возможен вариант, когда у второй ступени загрузочного кода gptzfsboot и zfsloader будут разные представления о таблицах разделов.

В итоге, я написал вот такой вот патч, который решает часть проблем, но всё же далеко не идеален. Хотя, судя по отзывам увеличивает скорость инициализации загрузчика на порядок.

В идеале же хочется выделить логику работы с таблицами разделов (а он встречается в sys/boot не один и не два раза) в отдельные файлы с необходимым интерфейсом, не зависящим от libstand(3). Но пока работа в этом направлении идёт неспешно.